Descubierta, actualmente sin indexar
La URL existe para Google, pero pueden faltar prioridad interna, crawl demand, enlaces o una razón suficiente para procesarla.
RASTREO E INDEXACIÓN
Diagnóstico de descubrimiento, crawling, rendering e indexación URL a URL
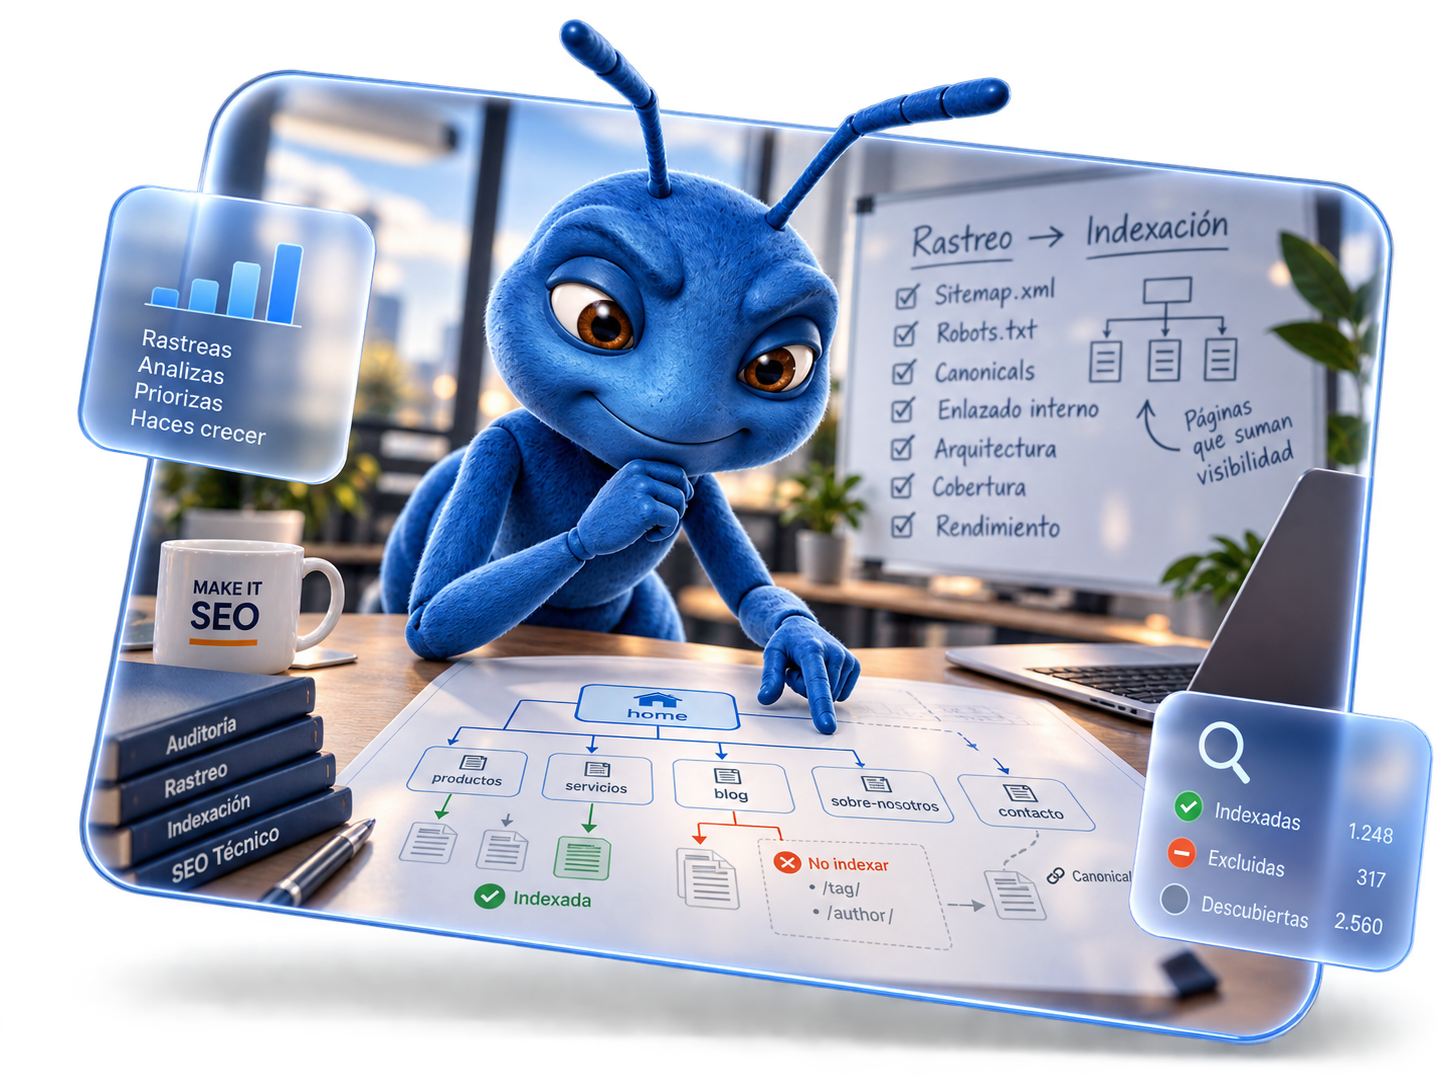
No todas las URLs deben indexarse. El trabajo consiste en saber cuáles deberían competir, qué etapa está fallando y qué señal técnica o de arquitectura explica el estado observado.
Esta página forma parte de nuestro servicio de SEO técnico.
El punto de partida
La URL existe para Google, pero pueden faltar prioridad interna, crawl demand, enlaces o una razón suficiente para procesarla.
Google ha solicitado la URL; ahora hay que revisar similitud, utilidad, señales canónicas y contexto del conjunto.
La etiqueta declarada compite con contenido, enlaces, redirects o sitemap que apuntan en otra dirección.
Se mezclan URLs estratégicas con parámetros, duplicados o páginas que nunca deberían formar parte del índice.
Nuestra respuesta
Analizamos el ciclo completo y definimos el estado esperado antes de recomendar una acción.
Enlaces, sitemap, rutas y profundidad.
Acceso, robots, respuesta HTTP y consumo de crawl.
Contenido y señales después de ejecutar la página.
Elegibilidad, similitud, utilidad y noindex.
Canonical elegida, inspección, logs y seguimiento.
Alcance
Search Console
Interpretar estados por plantilla y prioridad.
Acceso y rastreo
Comprobar que el bot puede llegar a lo importante.
Espacios de URLs
Evitar que la escala cree ruido innecesario.
Evidencia avanzada
Confirmar comportamiento real cuando hace falta.
Encaje
Para comprobar si Google las descubre, prioriza y procesa al ritmo esperado.
Para separar landings con demanda de combinaciones que consumen crawl sin aportar valor.
Para validar redirects, discovery, canonicals y sustitución progresiva de URLs antiguas.
Para diagnosticar la etapa concreta en lugar de pedir indexación de forma repetitiva.
Probablemente no lo necesitas si…
Clasificamos URLs por plantilla, intención y estado esperado: indexable, no indexable, temporal, histórica o sustituida.
Cruzamos crawl, GSC, sitemap, enlaces, canonicals, renderizado y, si aporta valor, logs.
Priorizamos patrones que afectan a páginas estratégicas o crean espacios de URLs innecesarios.
Aplicamos cambios en discovery, enlaces, canonicals, robots, sitemaps, redirects o contenido según la causa.
Validamos con crawl, inspección, cobertura y evolución del segmento, sin confundir una solicitud de indexación con la solución.
El sitemap y la navegación reflejan las URLs que realmente queremos poner a competir.
Parámetros, filtros y rutas recursivas dejan de multiplicar discovery sin valor.
Cada estado de GSC se interpreta según plantilla, señales y función esperada.
La arquitectura facilita que bots y usuarios lleguen antes a las páginas estratégicas.
Dudas
Puede haber varias causas: similitud, baja utilidad, señales canónicas, estado de la plantilla, calidad del conjunto o simplemente una decisión de selección. El estado de GSC es una pista, no una causa única.
No. El sitemap facilita descubrimiento y diagnóstico, pero no obliga a Google a indexar ni mejora el ranking por sí mismo.
No como regla general. robots.txt controla rastreo; no es una herramienta fiable de desindexación y puede impedir que el bot procese otras señales.
Significa que las señales observadas no han llevado al buscador a seleccionar la URL preferida que declaraste. Hay que revisar equivalencia, enlaces, redirects, sitemap y canonical.
En sitios grandes sí tiene sentido optimizar el espacio de URLs, rutas y respuestas que consumen rastreo. En webs pequeñas suele ser más útil mejorar arquitectura e indexabilidad.
Diagnosticamos discovery, crawling, render, indexación y selección antes de tocar robots, canonicals o sitemaps por intuición.
REVISAR RASTREO E INDEXACIÓN